 одами корпоративный IT-сектор исходил из наивного убеждения: чем больше параметров у нейросети, тем выше отдача для бизнеса. Команды по умолчанию отправляли базовые задачи во внешние облачные API, мирясь с непредсказуемыми задержками, счетами за каждый токен и рисками утечки конфиденциальных данных. Этот подход устарел. Современные компактные языковые модели (SLM) размером от 1B до 13B параметров научились работать быстро и решать прикладные задачи прямо на потребительском кремнии, не выпуская корпоративные данные наружу.
Отказ от счетов за токены и рисков утечки
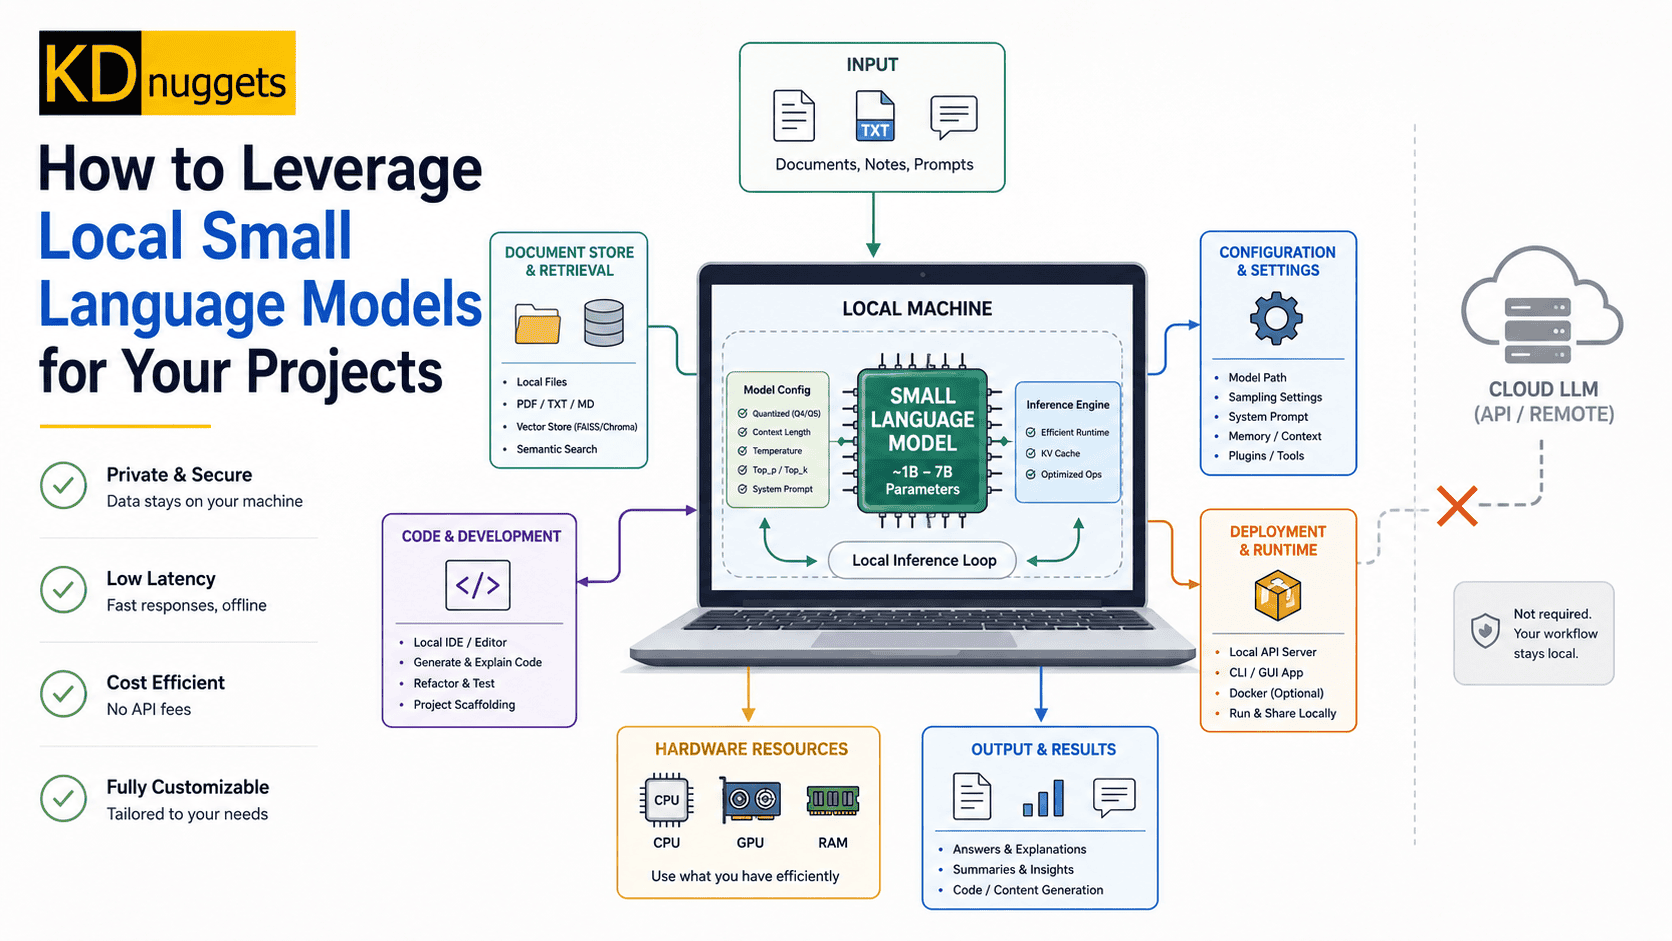
Экономический смысл локального запуска SLM сводится к прозрачности расходов и защите периметра. Тарифы облачных API растут прямо пропорционально нагрузке, превращая типовые внутренние инструменты в источник неконтролируемых операционных затрат. Переход на локальные веса заменяет постоянные транзакционные расходы разовыми вложениями в железо. В итоге команды могут без лишних затрат запускать конвейеры по извлечению данных из документов, локальный поиск и QA-системы.
Когда модель работает на вашем собственном устройстве, промпты и результаты генерации никогда не покидают изолированный контур.
Автономный инференс полностью исключает передачу данных сторонним сервисам — это критическое требование для регулируемых отраслей, работающих с проприетарным исходным кодом, медицинскими картами или финансовой отчетностью. Отсутствие сетевых задержек также срезает время отклика: автодополнение кода и ответы на запросы выдаются практически мгновенно по сравнению с удаленными очередями облачных платформ.
Расчет параметров под реальное железо
Отказ от подписок требует трезвого расчета памяти, а не абстрактного энтузиазма. Главным ограничением выступает объем памяти — объединенной RAM в Apple Silicon или выделенной VRAM у дискретных видеокарт Nvidia. Модели на 7 млрд параметров стали оптимальным стандартом для рабочих станций: в 4-битном квантовании (GGUF/AWQ) им требуется около 8 ГБ видеопамяти или системного пула. Для плавной генерации токенов на моделях класса 13B без ухода в медленный своп потребуется уже не менее 16 ГБ памяти.
Реальные операционные компромиссы
Локальное развертывание не делает флагманские облачные модели ненужными. Компактные локальные SLM ограничены по размеру контекстного окна и уступают гигантам в нетривиальных многоэтапных логических рассуждениях. Если задачи требуют глубокого анализа огромных массивов информации или сложной математики, централизованные API остаются безальтернативными. Однако в сценариях массовой классификации текстов, повседневного автодополнения кода и поиска по закрытым базам знаний компактные модели на локальном железе уверенно выигрывают по стоимости, скорости и приватности.