 ерестаньте ориентироваться на скорость генерации при выборе локальной модели искусственного интеллекта для ноутбука. Высокий показатель токенов в секунду отлично смотрится в таблице характеристик, но в реальной работе вы рискуете провести перед пустым экраном заметно больше времени, чем при использовании более медленного решения.
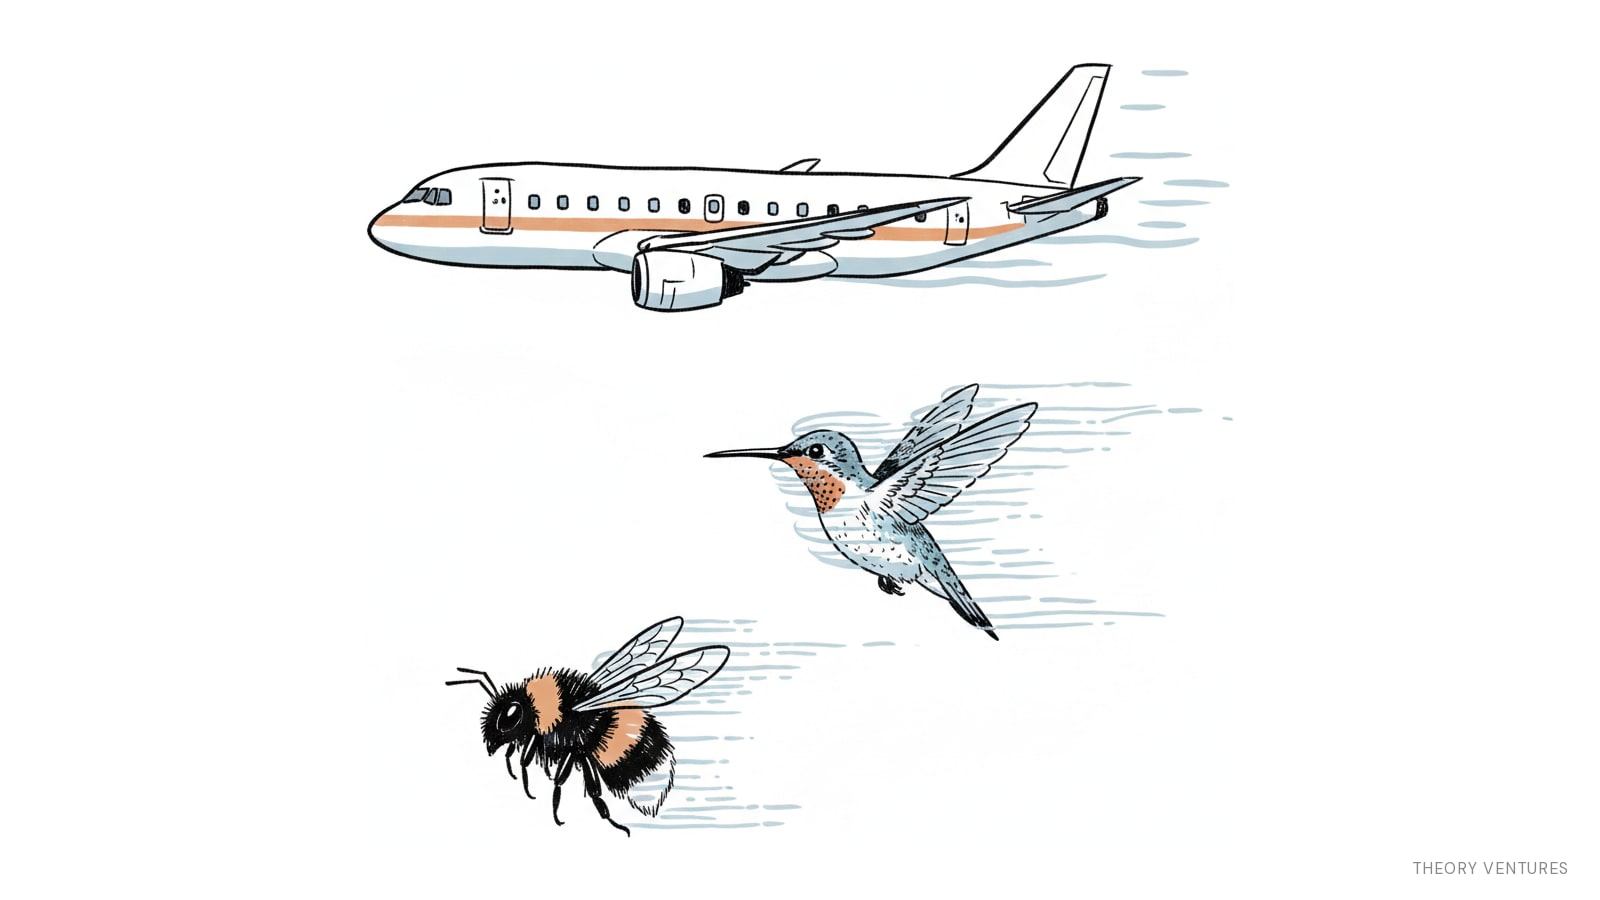
Как отметил венчурный инвестор Томаш Тунгуз, модель Qwen3.6-35B-A3B печатает текст со скоростью 113,4 токена в секунду — это более чем в 2,2 раза быстрее Qwen3.8-27B с ее 51,9 токена в секунду. Однако внешне быстрая модель справляется с реальной задачей медленнее: в среднем за 10,0 секунд против 7,2 секунды у версии на 27 млрд параметров по итогам 25 тестовых сценариев. Причина кроется в избыточных скрытых вычислениях: вариант 35B тратит 1143 токена на внутренние рассуждения — это в 3,1 раза больше предварительных размышлений, чем 369 токенов у 27B, прежде чем показать итоговый ответ. В одном из крайних случаев модель сгенерировала 993 скрытых служебных токена только ради того, чтобы выдать классификацию из шести слов.
Оценивать локальные модели по скорости печати бессмысленно: на практике важно только общее время до получения ответа. Кроме того, для решения сложных задач больше не нужны дорогие облачные подписки. В рейтинге Intelligence Index от аналитического сервиса Artificial Analysis компактная Qwen3.8-27B заняла первое место среди 135 моделей с 52 баллами, обойдя облачного гиганта GLM-5.2 от Z.ai на 753 млрд параметров с 51 баллом. Современные процессоры ноутбуков в паре с лаконичными и оптимизированными локальными моделями обеспечивают точность на уровне передовых облачных систем, не растрачивая заряд батареи и время на бессмысленные внутренние монологи.