 апуск автономных ИИ-агентов на собственном компьютере долгое время требовал болезненных компромиссов. Модели размером до 14 млрд параметров постоянно путаются во внешних инструментах, решения среднего уровня намертво зависают при первой же синтаксической ошибке в коде, а флагманские гиганты требуют ферм из нескольких серверных видеокарт, которые просто не поместятся в обычный корпус. Релиз открытой модели Muse Glimmer 30B от Meta (под лицензией Apache 2.0) решает именно эту проблему. Вместо того чтобы прикручивать поддержку сторонних инструментов задним числом, разработчики изначально натренировали модель на многоэтапные рабочие процессы: она умеет сама находить сбои в коде и исправлять их без подсказок человека.
Как уместить модель в одну видеокарту
Возможность запуска полноценного автономного помощника в обычном системном блоке упирается исключительно в объем видеопамяти. В архитектуре Muse Glimmer используется гибридное внимание: 32 слоя скользящего окна сочетаются со стандартными слоями в пропорции 3:1. Проще говоря, это не дает модели мгновенно забить всю видеопамять по мере роста истории диалога и объема рабочих заметок.
Кэш контекста требует всего около 52 КиБ на токен против 64 КиБ у Qwen 3.6 27B и внушительных 840 КиБ у Gemma 4 31B.
Благодаря такой экономии сжатые версии модели (например, сборка UD-Q4_K_XL от Unsloth) занимают около 20 ГБ видеопамяти. Это оставляет солидный запас на видеокарте с 32 ГБ памяти для обработки длинных цепочек рассуждений и логов без риска аварийного вылета из-за нехватки ресурсов.
Производительность и повседневные задачи
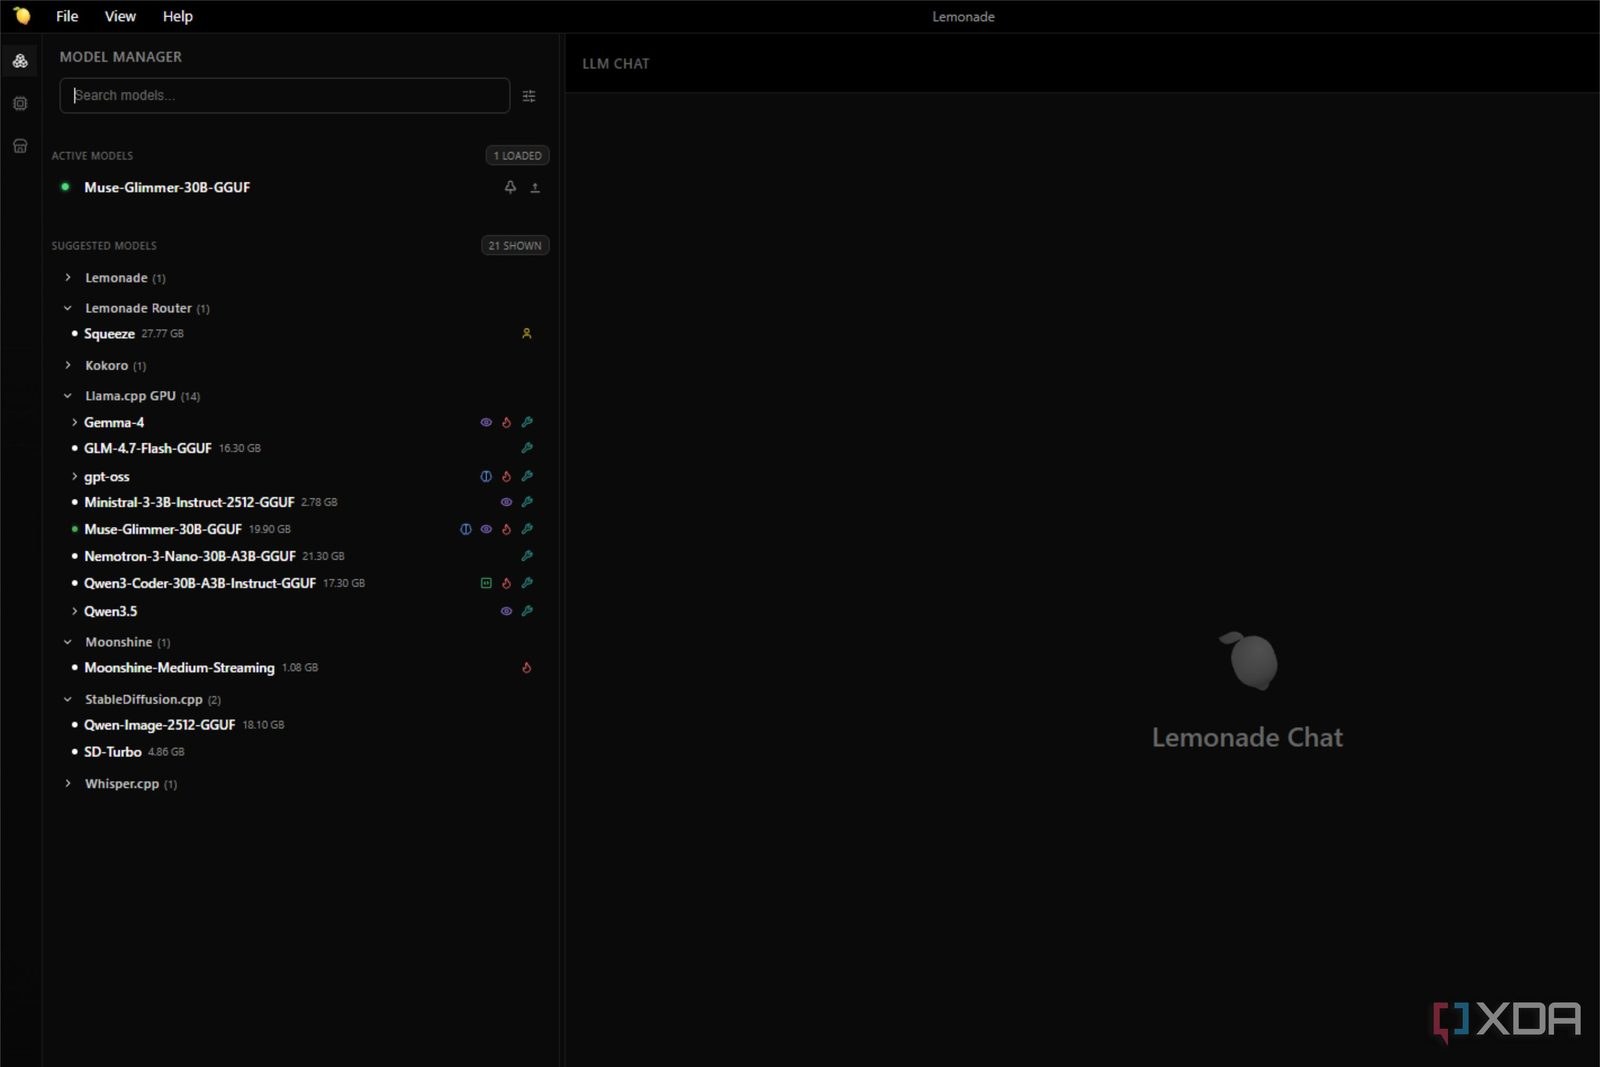
Что касается чистой скорости, на видеокарте RTX 5090 модель от Meta выдает базовые 74,9 токена в секунду, а при использовании оптимизированного алгоритма DFlash разгоняется до 233,4 токена в секунду. Программная экосистема развивается параллельно: стек AMD Lemonade, начиная с версии 11.6, получил встроенную поддержку быстрого декодирования, работу со зрительными данными и прямой запуск локальных инструментов под эту архитектуру.
Покупка мощной видеокарты на 32 ГБ перестает быть дорогой игрушкой для энтузиастов. Это позволяет полностью отказаться от ежемесячных платных подписок на облачные сервисы, сохранить конфиденциальные данные внутри собственного ПК и получить надежного цифрового ассистента, способного самостоятельно исправлять свои ошибки прямо на рабочем столе.